

导读:数据质量不理想并不意味着AI商品决策无法启动,但必须缩小首期场景、明确数据边界,并把数据治理纳入实施过程。本文说明如何划分可用数据、确定治理优先级,以及判断何时适合扩大应用。
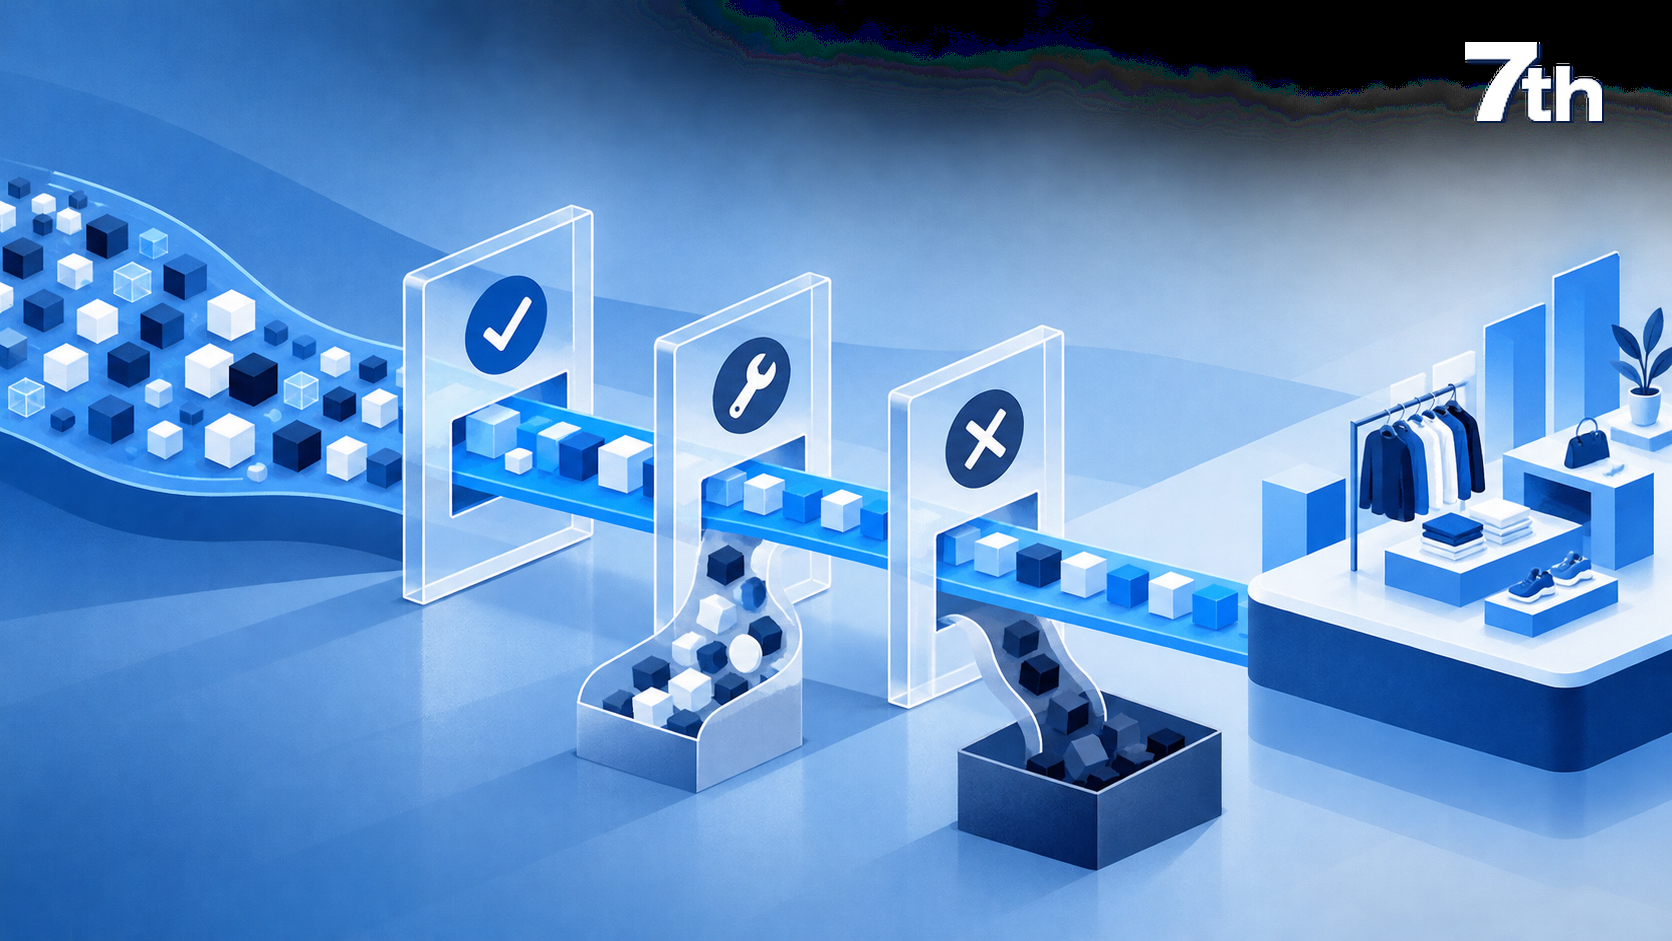
数据质量不好并不意味着AI商品决策必须停在原地;它意味着品牌需要缩小首期场景、明确不确定性,并把数据治理纳入项目本身。最危险的做法不是数据暂缺,而是将口径不一致、时间滞后或覆盖不全的数据直接输出为精确补货量,再把责任交给模型。
第一类是可直接用于首期场景的数据,例如商品、门店和已核对的净销售。第二类是治理后可用的数据,例如有数量但缺到货日的在途,或未标记活动的线上销售;它们可用于观察,不应用于完整库存位置判断。第三类是暂不进入决策的数据,例如长期缺失、权限不清或无法判断归属的加盟库存。
这种分类比笼统评价“数据好不好”更有用:每条建议都应知道自己依赖了哪些数据,以及哪些缺口可能改变结论。
优先治理与首个业务动作直接相关的数据。若先做补货,要先统一净销售、未承诺可售库存、订单和锁定量、在途到货日、关键尺码和销售窗口;若先做新品跟进,则重点补齐上市起算、有效铺货、可售天数、价格促销和退货处理。鞋服场景还要避免把长期断码后的销售比例直接当作真实尺码需求。
数据质量还包括更新时间、覆盖率和责任人。加盟、经销或线上渠道数据不完整时,结论应标明覆盖范围,而不是外推到全渠道。
当首期建议能够稳定说明数据口径、证据与约束,且人工复核发现的问题可持续修复时,再扩展到更多品类和动作。第七在线可在项目配置和人工审核下,辅助从有限场景开始形成建议;实际范围取决于接入数据与治理进度。若品牌正处于数据治理初期,可先做一次场景字段盘点,划出“可用、待治理、暂不使用”的边界。
答:可以做有限范围的预测或提示,但必须说明样本和假设,不能把它当作全渠道精确结论。
答:不必。应避免等待“完美数据”,也避免越过当前数据边界做高影响自动决策。
如果您正在评估AI商品决策的数据基础,可从一个边界清晰的场景开始盘点字段、口径、覆盖率和治理责任,预约AI商品决策数据评估。
 预约演示
 电话沟通
 微信咨询


 400-774-7617